Machine Learning en production : pièges à éviter
📋 Sommaire
Vous avez entraîné un modèle de Machine Learning prometteur, les métriques sur vos jeux de test sont excellentes, et l’équipe Data Science est enthousiaste. Puis vient le moment fatidique : la mise en production. Et c’est là que tout peut basculer.
La réalité des projets ML en entreprise est souvent décevante, non pas par manque de compétences techniques, mais à cause de pièges organisationnels et opérationnels que l’on n’anticipe pas assez tôt. Dérive silencieuse des données, absence de monitoring, dette technique accumulée, gouvernance floue : ces problèmes surgissent rarement en phase de développement, mais ils paralysent les équipes une fois le modèle exposé en conditions réelles.
Cet article s’adresse aux managers IT, Product Owners, Scrum Masters et décideurs tech qui pilotent ou supervisent des projets intégrant de l’intelligence artificielle. Nous allons parcourir ensemble les quatre grandes familles de pièges à éviter, avec des exemples concrets et des pistes d’action immédiatement applicables.
Le fossé entre le laboratoire et la réalité de production
Le premier piège est aussi le plus insidieux : confondre la performance d’un modèle en phase d’expérimentation avec sa robustesse en conditions réelles. Un modèle entraîné sur des données historiques propres, bien équilibrées et soigneusement préparées par l’équipe Data Science ne rencontrera jamais exactement le même contexte une fois déployé.
Le problème du data leakage
Le data leakage est l’un des coupables les plus fréquents. Il se produit lorsque des informations du futur contaminent les données d’entraînement. Résultat : le modèle affiche des performances flatteuses en validation croisée, puis échoue dès sa première semaine en production. Ce n’est pas un bug logiciel, c’est une erreur de conception du pipeline de données.
Cas de figure typique : une équipe entraîne un modèle de scoring client en incluant par inadvertance une variable calculée après la décision que le modèle est censé prédire. L’erreur reste invisible jusqu’au déploiement réel.
Des données de production jamais identiques aux données d’entraînement
En production, les données arrivent en flux continu, parfois incomplètes, parfois dans un ordre différent, parfois issues de sources qui évoluent sans prévenir. Il est essentiel de valider dès la phase de conception que le pipeline de features en production est strictement identique à celui utilisé lors de l’entraînement.
Un écart même mineur, par exemple une normalisation appliquée différemment, suffit à dégrader silencieusement les prédictions. Pour éviter cela, on recommande de versionner non seulement le modèle, mais aussi le code de transformation des données associé.
La dérive des données : un ennemi lent et silencieux
Imaginez un modèle de prévision de la demande déployé en début d’année. Il fonctionne correctement pendant trois mois, puis ses recommandations deviennent progressivement aberrantes. Personne ne s’en aperçoit immédiatement car la dégradation est graduelle. Quand le problème remonte enfin au Product Owner, le modèle produit des erreurs depuis des semaines.
Ce scénario illustre le phénomène de data drift : la distribution statistique des données en entrée change au fil du temps, sans que le modèle ne soit mis à jour pour s’y adapter.
Deux types de dérives à distinguer
- Le data drift : les caractéristiques des données d’entrée évoluent (comportement des utilisateurs, saisonnalité non anticipée, changement dans un système source).
- Le concept drift : la relation entre les variables d’entrée et la cible change, même si les données semblent stables en surface. C’est le plus difficile à détecter.
Mettre en place un monitoring adapté
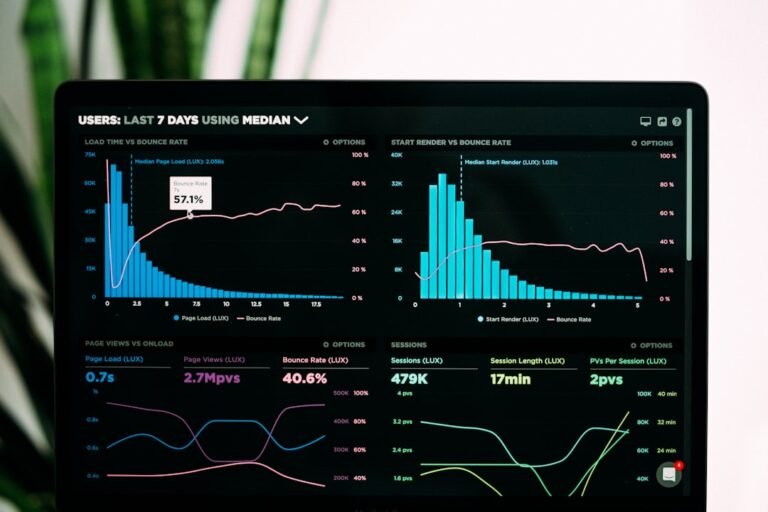
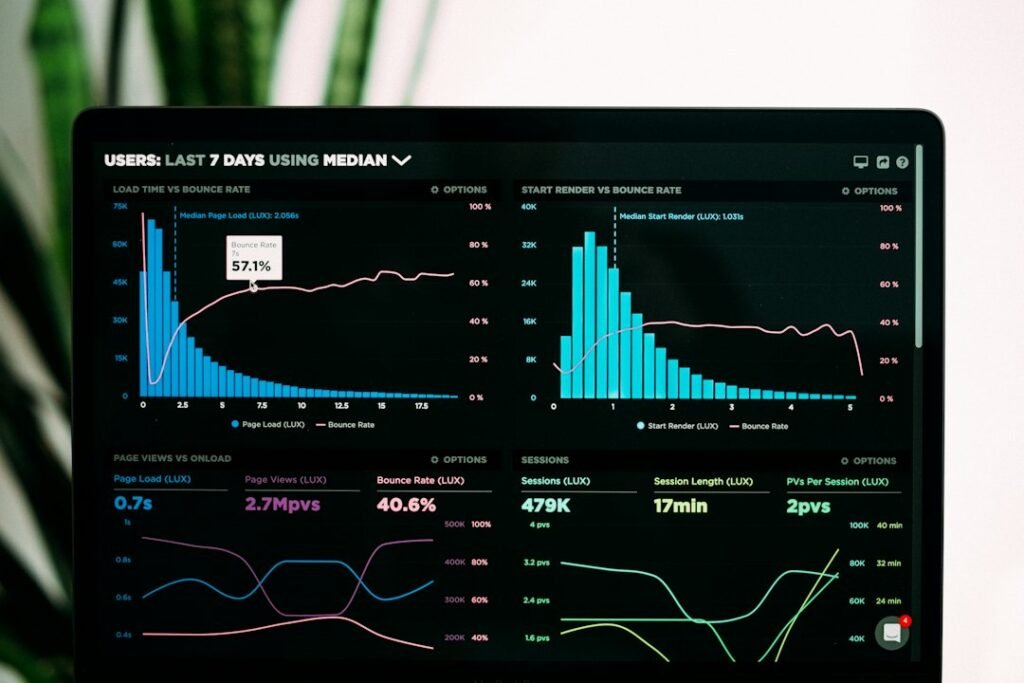
Sans monitoring actif, un modèle ML en production est une boîte noire. Les équipes doivent instrumenter leurs pipelines avec des alertes sur des indicateurs clés : distribution des variables d’entrée, taux de prédictions hors limites, évolution de la métrique métier associée au modèle.
Des outils comme Evidently AI, Whylogs ou des solutions intégrées dans les plateformes MLOps permettent d’automatiser cette surveillance. L’important n’est pas l’outil choisi, c’est la discipline organisationnelle qui consiste à traiter les alertes de dérive aussi sérieusement qu’une alerte d’infrastructure.
Côté gouvernance, il est utile de définir en amont un seuil de déclenchement au-delà duquel un réentraînement ou une révision du modèle est imposé. Ce seuil doit être co-construit avec les équipes métier, pas uniquement avec les data scientists.
La dette technique et organisationnelle des projets ML
Les projets ML accumulent une forme de dette technique particulièrement sournoise, car elle se constitue à plusieurs niveaux à la fois : le code du modèle, les pipelines de données, la gestion des versions, et même la documentation.
Des notebooks en production : le scénario catastrophe
L’un des anti-patterns les plus répandus est le déploiement direct d’un notebook Jupyter en guise de solution de production. Pratique pour l’expérimentation, le notebook n’est pas conçu pour être maintenu, versionné, testé unitairement ou exécuté de manière fiable dans un environnement automatisé.
Lorsqu’un data scientist quitte l’équipe et que son notebook est le seul artefact disponible, l’équipe se retrouve dans l’incapacité de faire évoluer ou de corriger le modèle sans repartir presque de zéro. La transition vers du code Python structuré, modulaire et testé n’est pas un luxe : c’est une condition de pérennité.
Le versioning, parent pauvre des projets ML
Contrairement au développement logiciel classique, les projets ML doivent versionner trois dimensions à la fois : le code, les données et le modèle lui-même. Oublier l’une de ces dimensions rend la reproductibilité impossible.
Si vous ne pouvez pas réentraîner exactement le même modèle à partir d’un commit donné, vous avez un problème de gouvernance. Des outils comme DVC (Data Version Control) ou les registres de modèles intégrés aux plateformes MLOps (MLflow, Azure ML, Vertex AI) apportent une réponse concrète à ce besoin.
L’absence de tests automatisés
Les tests unitaires et d’intégration sont une pratique bien établie en développement logiciel. En Machine Learning, ils restent trop souvent absents. On peut pourtant tester la cohérence du schéma de données en entrée, les bornes des prédictions, la non-régression des performances après un réentraînement, ou encore la latence du modèle sous charge.
Intégrer ces vérifications dans une CI/CD adaptée au ML (ce que l’on appelle le MLOps) est la condition pour déployer avec confiance et fréquence.
Gouvernance, conformité et éthique : des angles morts dangereux
Au-delà des aspects techniques, les projets ML en production soulèvent des enjeux de gouvernance que les décideurs ne peuvent plus ignorer. Le cadre réglementaire évolue rapidement en Europe, et les organisations qui n’anticipent pas ces contraintes s’exposent à des risques juridiques et réputationnels concrets.
L’IA Act européen change les règles du jeu
Le règlement européen sur l’intelligence artificielle, connu sous le nom d’AI Act, introduit une classification des systèmes IA par niveau de risque. Les systèmes à risque élevé, notamment ceux qui interviennent dans des décisions affectant des personnes (recrutement, crédit, accès à des services), devront respecter des exigences strictes en matière de documentation, de traçabilité et d’auditabilité.
Les équipes IT et les décideurs doivent intégrer dès maintenant ces contraintes dans leur cycle de vie ML, et ne pas traiter la conformité comme un chantier post-déploiement. Pour plus de détails, la documentation officielle de l’AI Act est disponible en ligne.
L’explicabilité, une exigence métier autant que réglementaire
Un modèle qui prend des décisions sans pouvoir les expliquer est un modèle difficile à défendre face aux utilisateurs, aux auditeurs et aux équipes métier. L’explicabilité n’est pas seulement une contrainte réglementaire : c’est aussi un levier de confiance et d’adoption.
Des approches comme SHAP ou LIME permettent d’interpréter les prédictions de modèles complexes. Les intégrer dès la phase de conception, plutôt qu’en post-production, simplifie considérablement la démarche.
La qualité des données, socle de toute conformité
Un modèle entraîné sur des données biaisées reproduit et amplifie ces biais en production. La gouvernance des données, c’est-à-dire la définition claire des sources, des règles de transformation, des politiques de rétention et des processus de qualité, est donc un prérequis absolu avant tout déploiement.
Sans catalogue de données, sans propriétaire identifié pour chaque jeu de données, et sans processus de validation régulière, les équipes naviguent à vue. Ce n’est plus acceptable dans un contexte où les modèles prennent des décisions qui impactent directement des utilisateurs finaux.
Conclusion
Mettre un modèle de Machine Learning en production est un défi qui dépasse largement la data science. Les pièges les plus coûteux ne sont pas techniques : ils sont organisationnels, méthodologiques et gouvernementaux.
Pour récapituler, les quatre zones de risque prioritaires sont : la confusion entre performance en laboratoire et robustesse réelle, l’absence de monitoring face à la dérive des données, la dette technique accumulée par des pratiques d’ingénierie insuffisantes, et les angles morts liés à la conformité et à la gouvernance des données.
Chacun de ces enjeux nécessite une réponse structurée, portée conjointement par les équipes Data, IT et les décideurs métier. C’est précisément l’approche que TechWise Solutions met en oeuvre pour accompagner les organisations françaises dans la sécurisation de leurs projets IA et MLOps.
Vous souhaitez évaluer la maturité ML de votre organisation ou cadrer votre prochain déploiement ? Contactez nos experts TechWise Solutions pour un échange sans engagement.
Besoin d’un accompagnement IT ou Agile ?
TechWise Solutions accompagne vos équipes sur le conseil IT, le coaching agile et SAFe, et la transformation digitale.